前言
就在今天(2026 年 7 月 31 日),DeepSeek 官方发布了 DeepSeek-V4-Flash 正式版 API 公测。距离 4 月 24 日 V4 预览版发布过去大概三个月,这次更新的重点关键词只有一个——Agent 能力大幅跃升。
这次官方直接公布了 9 项基准测试成绩,多项指标远超此前发布的 V4-Pro-Preview,甚至可以说是”以下犯上”了,颇有当初 V4 发布时”倒反天罡”的味道。
先简单回顾一下 V4 系列
2026 年 4 月 24 日,DeepSeek 无预警发布了 V4 系列,包含 Pro 和 Flash 两个版本:
| 对比项 | V4-Pro | V4-Flash |
|---|---|---|
| 总参数 | 1.6T | 284B |
| 激活参数 | 49B | 13B |
| 架构 | MoE | MoE |
| 上下文 | 1M tokens | 1M tokens |
| 最大输出 | 384K tokens | 384K tokens |
Pro 主打性能上限,对标闭源旗舰模型;Flash 则在参数规模上大幅缩小,换取更低延迟和更低成本,主打性价比。而这次正式版的 Flash,把 Agent 能力拉到甚至超越了 Pro 预览版的水平——这就很有意思了,毕竟两边参数规模差了将近一个数量级。
九项基准测试成绩单
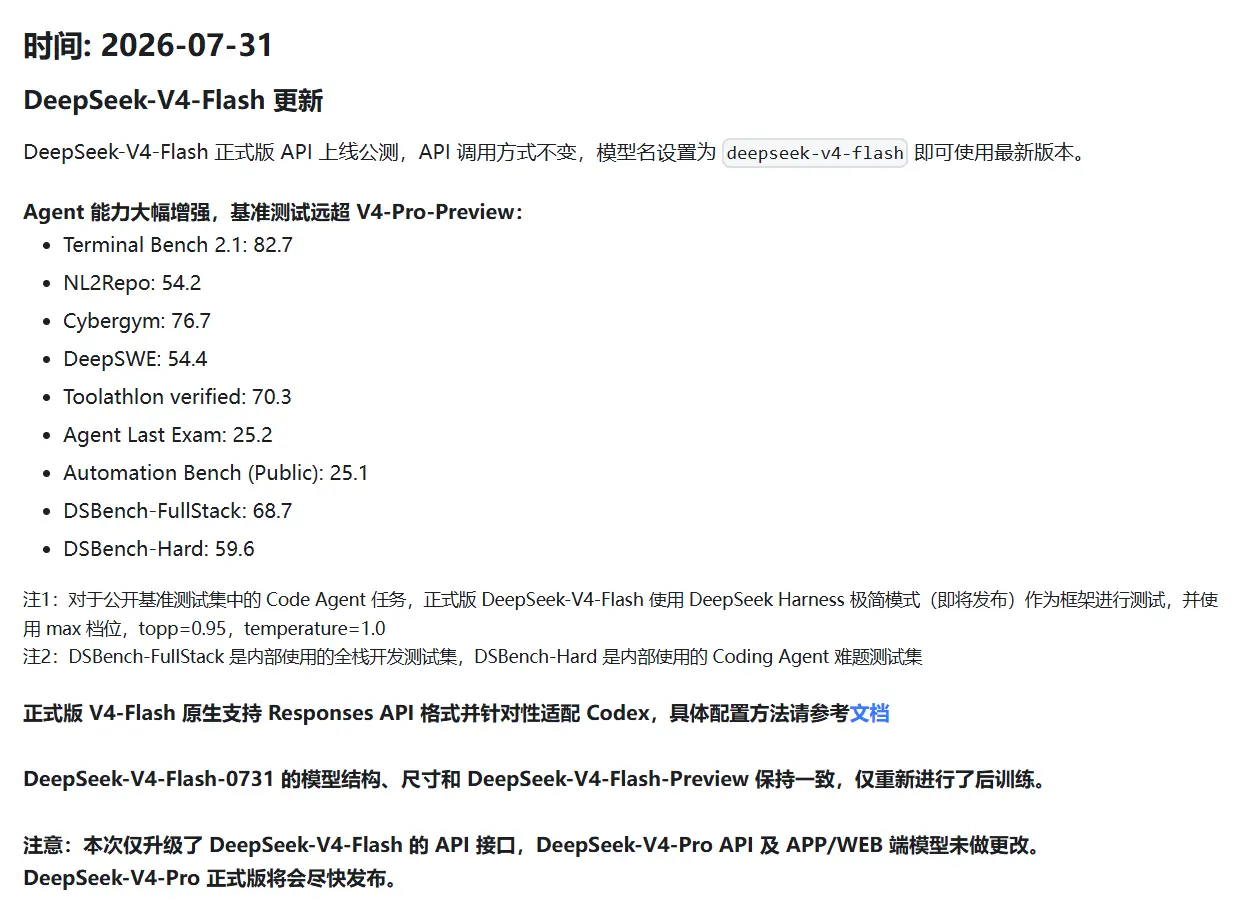
官方更新日志披露的完整成绩如下:
| 基准测试 | 得分 |
|---|---|
| Terminal Bench 2.1 | 82.7 |
| NL2Repo | 54.2 |
| Cybergym | 76.7 |
| DeepSWE | 54.4 |
| Toolathlon Verified | 70.3 |
| Agent Last Exam | 25.2 |
| Automation Bench (Public) | 25.1 |
| DSBench-FullStack(内部测试集) | 68.7 |
| DSBench-Hard(内部测试集) | 59.6 |
几个值得注意的点:
- Terminal Bench 2.1 拿到 82.7,官方此前公布 V4-Pro-Preview 在 Terminal Bench 2.0 上是 67.9 分。虽然 2.0 和 2.1 不是同一版本测试集,直接对比不完全公平,但一个激活参数仅 13B 的轻量版能跑到这个分数,已经很能说明问题了。
- Cybergym 76.7,这是网络安全攻防模拟测试,说明模型在安全对抗场景下也有不错的发挥。
- DSBench-FullStack 和 DSBench-Hard 是官方内部的测试集,分别是全栈开发测试和 Coding Agent 难题测试。作为内部测试集公开出来,侧面印证了 DeepSeek 想把 Flash 打造成开发者与 Agent 应用首选底座的意图。
官方还披露了测试条件:公开基准集中的 Code Agent 任务,使用了即将发布的 DeepSeek Harness 极简模式作为框架测试,max 档位,top_p=0.95,temperature=1.0。这里有个细节值得注意——DeepSeek 自研的 Harness 测试框架是首次以正式命名亮相,说明官方不只是想训练更强的模型,还想建立一套标准化的 Agent 评测生态。
模型结构没变,但是变得更强了
官方明确说明:DeepSeek-V4-Flash-0731 的模型结构、尺寸与 V4-Flash-preview 保持一致,仅重新进行了后训练。
底座没变,变的是训练方法。这其实释放了一个信号:在 Agent 能力这条赛道上,后训练策略的优化空间依然巨大。同样的模型架构,经过更精细的后训练调优就能在基准测试上产生质变——对行业来说,这比单纯堆参数更具参考意义。
顺带一提,V4 系列在长上下文效率上做了一系列激进优化,在 100 万 token 场景下 Flash 的单 token 推理计算量仅为 V3.2 的 10% 左右,KV Cache 占用也大幅下降,百万上下文不再是”富人专属”。这也是 Flash 能把价格压到这么低的原因之一。
原生支持 Responses API,适配 Codex
正式版 V4-Flash 原生支持 OpenAI 的 Responses API 格式,并针对性适配了 Codex。
所有 Codex 客户端——Codex CLI、ChatGPT 桌面端、VS Code 的 Codex 插件——共用同一份配置文件,配置一次即可全部生效。DeepSeek 官方还提供了 PowerShell 一行命令的自动配置脚本:
irm https://cdn.deepseek.com/api-docs/codex-deepseek-setup-en.ps1 | iex脚本会自动备份原有配置、写入 models.json 模型目录(声明上下文窗口、推理档位、工具调用格式等元数据)、修改 config.toml 并在写回前校验语法,出问题就中止不碰你的文件,还是挺稳的。
需要说明的是,目前只有 deepseek-v4-flash 支持接入 Codex,V4-Pro 预计要到 8 月初才支持。
价格
Flash 一如既往地走极致性价比路线,官方价格如下(百万 tokens,平峰时段):
| 计费项 | 平峰价格 | 高峰价格 |
|---|---|---|
| 输入(缓存命中) | 0.02 元 | 0.04 元 |
| 输入(缓存未命中) | 1 元 | 2 元 |
| 输出 | 2 元 | 4 元 |
| 并发限制 | 2500 | - |
对比 V4-Pro(平峰输入缓存命中 0.025 元、未命中 3 元、输出 6 元),Flash 的性价比优势还是很明显的,尤其是高并发场景下 2500 的并发上限非常宽松。
峰谷定价
V4 系列还引入了一个比较有意思的机制——峰谷分时定价,直接把电力市场的逻辑搬到了算力市场:
- 高峰时段:工作日北京时间每日 9:00-12:00 和 14:00-18:00(每天 7 小时)
- 平峰时段:其余 17 小时,加上周末与节假日全天
高峰时段所有计费项统一翻倍,相当于给 token 装上了”计价器”。大模型 API 定价从 GPT-3 时代到现在一直都是一口价,DeepSeek 算是行业里第一个吃螃蟹的。
这里有两个细节需要注意:
- 峰谷计费仅面向开发者 API 调用,C 端用户用 App/Web 聊天价格不变
- 平峰时段的价格与此前的定价保持一致,并不是先涨价再”做优惠”——高峰多付一倍,换来的是一份优先算力保障
对开发者来说,这个机制反而给了省钱的思路:数据清洗、文档总结、离线批量处理这类不要求实时返回的任务,错峰到夜间或周末跑成本直接减半;实时 Agent、在线客服这种吃高峰溢价的场景,就只能靠优化 prompt 长度和缓存来压成本了。再加上缓存命中的输入价格低到几乎可以忽略(0.02 元/百万),把固定的 system prompt、知识库前缀做好缓存,实际支出还能再压一截。
升级范围
需要注意,本次升级仅覆盖 V4-Flash 的 API 接口:
- 已升级:DeepSeek-V4-Flash API
- 未升级:DeepSeek-V4-Pro API
- 未升级:APP / WEB 端模型
- 即将发布:DeepSeek-V4-Pro 正式版(官方表示”将尽快发布”,网传可能在 8 月初)
所以如果你平时只用 DeepSeek 的 App 或网页端,今天打开对话窗口体验和昨天不会有任何区别。另外旧的 deepseek-chat 和 deepseek-reasoner 两个模型名已经在 7 月 24 日弃用,现在分别对应 deepseek-v4-flash 的非思考模式与思考模式。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 82 天
部分内容可能已过时